In het kort Data-gedreven werken in de logistiek begint bij een goede datastrategie en een stevige fundering. In dit artikel lees je waarom data zo vaak ongebruikt blijft, welke drie vragen daarbij steeds terugkomen (volume, vertrouwen en delen) en hoe een datawarehouse als gemeenschappelijke grond daar een antwoord op biedt. Aan de hand van de praktijk bij Moovle zie je wat dat oplevert: dashboards die het dagelijkse werk sturen en processen die zichzelf afhandelen.
Data: wat moet je ermee.
Als moderne organisatie in de logistiek genereer je meer data dan je ooit kunt lezen. Elk commercieel voertuig produceert inmiddels ruim 8.000 datapunten per dag: GPS-coördinaten, motordiagnostiek, brandstofverbruik, rijgedrag1. Vermenigvuldig dat met een wagenpark, tel er de ETA’s, kilometerstanden, douane-statussen, heffingen, orders en financiële gegevens bij op, en je hebt een stroom die geen mens meer overziet. De vraag is allang niet meer of je data hebt; de vraag is of je er iets mee kán.
Data-kundigheid blijkt een directe graadmeter voor succes. Uit onderzoek van S&P Market Intelligence blijkt dat 65% van sterk data-gedreven mkb-bedrijven financieel beter presteert dan de concurrentie, terwijl slechts 19% zichzelf als sterk data-gedreven beschouwt2. Datzelfde onderzoek laat zien dat organisaties met een volwassen datastrategie 60% vaker financieel beter presteren dan bedrijven die daar nog mee worstelen2.
Door de grote beschikbaarheid aan data hebben Nederlandse logistieke dienstverleners een positief toekomstbeeld en ze verwachten een gemiddelde productiviteitsstijging door automatisering van 17,6% binnen vijf jaar3.
Echter, één belangrijke voorwaarde geldt hier net zo goed als voor andere sectoren: het hebben van een valide datastrategie. Kortom: verzamel data, maar niet zonder plan om er daadwerkelijk iets mee te doen.
“We verzamelen data, maar niet als doel op zich. Uiteindelijk is de belofte dat data ons de feiten leveren die zorgen voor een betere informatievoorziening en besluitvorming. Dit geldt voor alle stakeholders: medewerkers in hun dagelijkse werk, het management in besluitvorming en procesverbetering. Maar ook klanten en leveranciers die afhankelijk zijn van onze informatievoorziening, bijvoorbeeld als het gaat om levertijden en nog te betalen facturen.”
Het ‘iets doen met data’ is precies waar het vaak misloopt. Data die je niet verwerkt, veroudert razendsnel: volgens IBM verliest ongeveer 60% van data onmiddellijk zijn waarde4. En het meeste blijft simpelweg liggen. Gartner schat dat wereldwijd zo’n 55% van alle bedrijfsdata “dark” is: wel opgeslagen, maar nooit gebruikt voor analyse of besluitvorming5. Bij sensor-gegenereerde data, het hart van elk telematica-systeem, loopt dat volgens IBM op tot 90% dat nooit wordt geanalyseerd6. De oorzaak is bijna altijd dezelfde: datasilo’s, genoemd door 82% van de organisaties als belangrijkste reden dat data ongebruikt blijft4. Alles komt binnen, maar overal op een andere manier, in een ander systeem, in een ander formaat.
Dat is zonde, want de winst ligt voor het oprapen. Organisaties die hun dark data onder de 30% weten te brengen, ervaren 1,8× snellere besluitvormingscycli4. In een sector waarin transport en logistiek al de grootste afnemer van GPS-tracking vormt7, en waarin inmiddels ruim 80% van de commerciële wagenparken telematica gebruikt1, is dat het verschil tussen vooroplopen en achteroplopen.
De noodzaak van een goede datastrategie is dus duidelijk, maar hoe je hiertoe komt is een complex vraagstuk. We zien hierover bij klanten steeds dezelfde drie hoofdvragen terugkomen:
- Volume. Hoe verwerk ik een grote hoeveelheid aan data tot bruikbare informatie?
- Vertrouwen. Welke data is de juiste? Waarop kan ik vertrouwen, en bij welke data mis ik de context die nodig is om erop te bouwen?
- Delen. Hoe maak ik dit beschikbaar? Hoe laat ik medewerkers, klanten en leveranciers er echt mee werken? Hoe creëer ik draagkracht voor een datagedreven manier van werken?
“Een gedocumenteerd plan dat bepaalt hoe een organisatie data verzamelt, beheert, beveiligt en inzet om haar bedrijfsdoelen te bereiken.”8
Definitie van een datastrategie, volgens Salesforce
Een golf aan snippers data.
Los van de gebruikelijke bedrijfsfuncties (Finance, HR, Marketing) zit in de logistieke sector het data-zwaartepunt in het operationele deel: alle containers en goederen die van A naar B gaan, de planningsdata, de statussen onderweg. En laat dat nou net het deel zijn waar je klant óók inzicht in wil. Voor één enkele vracht kost het bijhouden van de datastroom al aardig wat tijd en geduld, laat staan bij tientallen verplaatsingen tegelijk. En dan wil je ook nog groeien als bedrijf. Hoe moet dat dan?
Het laatste wat je wilt, is dat je datahuishouding de bottleneck van je groeidoelstellingen wordt. Dat is geen theoretisch risico: organisaties verliezen gemiddeld 12,9 miljoen dollar per jaar aan slechte datakwaliteit, en medewerkers besteden tot 27% van hun tijd aan het corrigeren van foute data in plaats van er beslissingen op te baseren9. Die rekening loopt op naarmate je groeit, want de grotere schaal maakt het steeds moeilijker om op een effectieve manier informatie te onttrekken uit data, terwijl de vraag naar goede informatie alleen maar meegroeit met je bedrijf.
Een struikelblok is soms al iets simpels als interne communicatie: een operationele manager die op zoek is naar cijfers die Finance al lang beschikbaar heeft of iemand die beslissingen baseert op data die hier niet voor is bedoeld.
Vaker zit het grotere, overkoepelende probleem in de data-infrastructuur zelf. Het bestaande systeem kan de groeiende instroom aan data simpelweg niet aan, of sluit maar matig, of zelfs helemaal niet, aan op wat werknemers nodig hebben. Als gevolg schaft elke afdeling zijn eigen apps aan, genereert zijn eigen data en verzint zijn eigen workarounds, wat de samenwerking tussen afdelingen juist ondermijnt. Zo ontstaan situaties waarin HR de verlofplanning van inhuurkrachten ‘tijdelijk’ bijhoudt in een Excel-bestand, dat vervolgens de spil, en uiteindelijk de bottleneck, van een volledig bedrijfsbreed proces wordt. Op die manier werkt elke afdeling, zonder het te beseffen, mee aan de versnippering van data binnen de organisatie.
Het is daarom belangrijk om zaken vooraf efficiënt in te richten en vanaf het eerste moment de schaalbaarheid in acht te nemen. Dit kost misschien op voorhand meer, maar zal op de lange termijn een hoop gedoe, en dus kosten, besparen.
De hooiberg is net zo relevant als de speld.
Naarmate het aantal datapunten groeit verlies je al snel het overzicht; wat niet handig is als je beslissingen wilt baseren op vergaarde feiten. Zoeken naar een specifiek datapunt (de speld in de hooiberg) voor inzicht heeft geen zin, want zonder context vertellen die je niets op zichzelf. Het is daarom juist interessant, en nodig, om de hele berg aan data in overweging te nemen in je beslissingen.
Deze volledige hooiberg structureel omzetten naar bruikbare informatie kan veel vragen van je digitale infrastructuur en de uitdaging ligt dan ook zelden bij een tekort aan analisten. Het doel is om op schaal data die verspreid ligt over silo’s en in verschillende talen spreekt te verzoenen tot een universele waarheid, zonder wekenlang handmatig werk7.
“Bij data zijn we niet alleen geïnteresseerd in de speld, maar juist ook in de hooiberg.”
Data in de juiste vorm, op de juiste plek, op het juiste moment.
In de dataketen is de levering van data aan je stakeholders de laatste stap, maar eigenlijk het eerste aanknopingspunt tijdens het formuleren van een effectieve datastrategie. Je kunt in het wilde weg data ophalen, verzamelen, aan elkaar knopen en visualiseren, maar hoe groot is de kans dat dat zomaar aansluit bij wat je stakeholders nodig hebben?
Uiteindelijk wil je dat medewerkers, leveranciers en klanten de data, en de systemen die erop draaien, daadwerkelijk gaan gebruiken. Dat ze het zien als single source of truth: één plek waarvan iedereen accepteert dat het klopt. Echter, vertrouwen op data is geen vanzelfsprekendheid. Uit onderzoek blijkt dat 77% van de IT-beslissers de data in hun eigen organisatie niet volledig vertrouwt voor tijdige en accurate besluitvorming, en de belangrijkste oorzaken zijn slechte datakwaliteit, versnipperde bronnen en vertraagde analyses10. Zolang mensen twijfelen aan de cijfers, vallen ze terug op hun onderbuik en blijft je hele data-investering ongebruikt.
Vertrouwen win je door mensen iets aan te bieden wat hen aanspreekt: in een vorm waar ze direct op kunnen acteren, en waar ze bij kunnen. Niet alleen fysiek, met de juiste rechten via een eigen portal of bijvoorbeeld Power BI, maar ook passend in hun workflow. Niet omslachtig én goed geïntegreerd. Alleen dan stoppen teams met ruziën over wat de cijfers zíjn en kunnen ze eindelijk praten over wat ze ermee gaan doen7.
Dat brengt ons bij het laatste stuk van de puzzel: timing. De data moet niet alleen kloppen, maar ook relevant zijn op het moment dat iemand hem nodig heeft. Hoe vaak verandert de brondata, en hoe snel moeten die wijzigingen zichtbaar zijn? Is een dagelijkse verversing voldoende, of is een live verbinding met de bron nodig? Het antwoord bepaalt in hoge mate hoe de uiteindelijke oplossing eruitziet, en het is een keuze die je aan de voorkant moet maken, niet achteraf.
Checklist voor succes.
Gewenst is een oplossing die je medewerkers in staat stelt om werk van hogere kwaliteit te leveren, in minder tijd, en managers afgewogen beslissingen laat maken op basis van goede informatie. Het moet niet afleiden van de kern, maar juist focus geven op de core business, het werk waarin jouw mensen het verschil maken, en hen hierin zo goed mogelijk ondersteunen.
En dat natuurlijk tegen een investering die het waard is: eentje die zich binnen afzienbare tijd terugverdient, het liefst zo snel mogelijk. Gelukkig bewijst de praktijk dat de terugverdientijden niet hoog hoeven te liggen; soms al tussen de drie en zes maanden11. Het is een van de weinige technologie-investeringen waar de rekensom vaak al klopt vóórdat je de pitch hebt afgerond.
Zo sluit de cirkel zich: je klanten worden beter bediend, je medewerkers zijn tevredener, en het is ook nog eens goed voor je marges. En wie verder wil kijken, optimaliseert dit systeem niet alleen op winst, maar op een triple bottom line, waarin ook people en planet meetellen. Want dezelfde data die je efficiënter maakt, laat je bijvoorbeeld ook je uitstoot nauwkeurig meten en terugdringen: DHL en UPS gebruiken telematica onder meer om hun CO₂-uitstoot met 15 tot 20% te verlagen1. Goed voor de wereld en de marge tegelijk: dat is precies het soort resultaat waar je naartoe werkt.
Waar de oplossing voor zorgt.
- Kwaliteit
- Beslissingen worden gemaakt op basis van data.
- Iedereen werkt met dezelfde cijfers.
- Kwantiteit
- Output is hoger met dezelfde inspanning.
- Focus core-business
- Randzaken worden uit handen genomen.
- We worden ondersteund in taken rond onze core-business.
- Business case
- De terugverdientijd van de oplossing past in het risicoportfolio van ons bedrijf.
- Ervaring klanten, leveranciers en partners
- Onze informatievoorziening draagt positief bij aan de relatie met externe stakeholders.
- Klimaat
- Systemen en automations optimaliseren mede op minimale uitstoot.
- Werkervaring
- Werknemers ervaren een hoger werkplezier door minder repetitief en handmatig werk.
Oplossing: een datawarehouse als gemeenschappelijke grond.
Het antwoord op al het bovenstaande begint bij één centrale keuze: een datawarehouse. Dat is een centrale database waarin je alle data uit je verschillende systemen samenbrengt en bijhoudt: een landingszone voor alle datastromen.
Waarom dat nodig is, wordt duidelijk als je kijkt naar hoe systemen met elkaar praten. Idealiter werkt elk systeem hetzelfde en spreken ze allemaal dezelfde taal, maar dat is zelden het geval. Bij een verschil in de manier van data bewaren en communiceren kan je proberen om directe koppelingen te bouwen tussen twee systemen: een soort tussenstation dat de ene taal naar de andere vertaalt. Dit kan perfect werken en is goed beheersbaar, maar als het aantal te koppelen systemen groeit, naar drie, vier of meer, loopt het aantal verbindingen razendsnel op, en verandert je landschap in een wirwar die niemand meer overziet. Precies de datasilo’s die eerder al voorbij kwamen.
Een datawarehouse draait die logica om. In plaats van elk systeem met elk ander systeem te verbinden, geef je ze allemaal één gedeelde landingszone. Elk systeem praat alleen nog met die centrale plek. En daar bovenop draaien de toepassingen die je medewerkers ondersteunen, werk uit handen nemen en stakeholders van de juiste informatie voorzien.
Een vast proces voor elke nieuwe bron.
Voor elke databron die je wilt aansluiten, bouw je een connector naar de centrale database. Dat doe je zo veel mogelijk op een gestandaardiseerde manier, zodat het toevoegen van een nieuwe bron altijd via hetzelfde vaste proces verloopt. Dat is handig voor softwareontwikkelaars in de samenwerking met collega’s, maar ook voor de AI-tools die ze gebruiken in hun werk. Het begrijpen en onderhouden van code die door AI is geschreven, is namelijk een stuk makkelijker als dit zich ook houdt aan een vooropgesteld kader en werkwijze.
Standaardisatie ondersteunt ook een modulaire aanpak, waarbij elk onderdeel van de keten op zichzelf staat en los van de rest kan worden ontwikkeld. Dit levert veel concrete voordelen op:
- Fouten opsporen wordt eenvoudig, omdat je precies weet in welke schakel iets misgaat.
- Onderhoud wordt beheersbaar, omdat je een onderdeel kunt aanpassen zonder de rest te raken.
- Overzicht over AI-code. Als ontwikkelaar houd je veel makkelijker overzicht over wat AI voor je codeert en hoe dat werkt. Taken die je delegeert zijn strak af te kaderen en er worden geen dingen buiten je zicht aangepast.
Snelheid en veiligheid door nabijheid.
De toepassingen en systemen die op het warehouse draaien, leven in dezelfde omgeving. Dat maakt alles sneller, omdat deze IT-resources, of ze nu in de cloud of lokaal draaien, dicht bij elkaar zitten en geen lange weg hoeven te reizen over het internet om elkaar te bereiken.
Het is ook veiliger, omdat de verschillende onderdelen onderling met elkaar kunnen communiceren en hiervoor geen toegang tot het internet nodig hebben. Toegang tot gevoelige data via het openbare internet kun je helemaal dichtzetten, en alleen toestaan vanaf je interne netwerk. Je data hoeft de beveiligde omgeving simpelweg niet te verlaten.
Geen gouden kooi: modulair betekent vrij.
Een laatste, onderschat voordeel van de modulaire opzet: je zit nergens aan vast. Het voorkomt vendor lock-in, de situatie waarin je zo verstrengeld raakt met één leverancier dat overstappen bijna onmogelijk wordt. Je kiest zelf welke database je gebruikt, waar je applicaties draaien, of je dat zelf beheert of uitbesteedt, en waar jij en je klanten de automatische rapportages bekijken.
Als voorbeeld:
- Maak je eigen klantportaal om rapportages op te bekijken en te delen met klanten, in plaats van vast te zitten aan Looker Studio (Google Cloud) of Power BI (Microsoft). Met een inlogsysteem voor klanten, je eigen branding, geïntegreerd in je eigen portal, website of ecosysteem.
- Verplaats zonder alles opnieuw te moeten doen de database van de server op kantoor naar de cloud. En kies om dit specifiek naar een server in Europa te doen, of juist ergens anders.
- Stap over op een ander ERP- of HR-systeem en zorg dat alle data uit de oude software bewaard blijft en vertaald wordt naar die uit je nieuwe omgeving.
Kortom: een modulaire opzet verlaagt risico en biedt veel extra functionaliteit.
Van plan naar praktijk: implementatie in de logistiek.
Vrijwel elke stap in de logistieke keten genereert data waar je iets mee kunt doen, en hiermee biedt dat dus alle ruimte om veel verschillende datakoppelingen te integreren in je bedrijf. Dat is een zegen, want meer informatie betekent minder risico. Tegelijk maakt dit de gehele data-infrastructuur een stuk complexer en omvangrijker. Hierbij een aantal tips en afwegingen om het proces op gang te helpen.
Begin bij het ERP-systeem.
De logische eerste koppeling is je ERP-systeem: het systeem dat je bedrijfsprocessen en resources centraal beheert. Dat is de rode draad van je organisatie en bevat ook je financiële data. Door hier te beginnen, kan de rest van je datalandschap zich hierop afstemmen. Prettig detail: de meeste grote aanbieders hebben goede API-koppelingen, standaard-toegangspunten waarmee andere systemen data kunnen ophalen, dus je kunt tot in detail configureren welke data op welk moment wordt opgehaald.
Daarna volgt stapsgewijs de rest: kilometerregistratie, vracht- en containertracking, losstaande HR-systemen, urenregistratie, douaneprocessen, specifieke e-mailinboxen. Velden die in meerdere bronnen terugkomen worden gestandaardiseerd en in hetzelfde format opgeslagen; denk aan datums, financiële bedragen, gewicht, afstanden, namen van landen en plaatsen, enzovoort. Het is handig om deze standaarden op te stellen aan de hand van je ERP-systeem, zodat je datawarehouse, en daarmee ook toekomstige automatiseringen, optimaal afgesteld zijn op je belangrijkste systeem.
De infrastructuurkeuze: cloud, lokaal of beide.
Waar je alles onderbrengt is een echte afweging, en het antwoord verschilt per bedrijf. De infrastructuur kan lokaal op kantoor staan, in de cloud, of een combinatie van beide. Elke variant heeft eigen trade-offs en een eigen prijskaartje.
Voor relatief kleine oplossingen is de cloud vaak goedkoper, omdat je betaalt voor wat je gebruikt. Voor minder dan 50 euro per maand draai je in de cloud al iets waar je als klein bedrijf veel mee kunt. Maar let op: cloudkosten schalen met gebruik. Zodra je meer vraagt, een live verbinding in plaats van een dagelijkse verversing, of een eigen rapportageplatform, schiet die actieve tijd omhoog, en de kosten. Dan wordt het op een gegeven moment aantrekkelijker om een server te huren of er zelf een aan te schaffen.
Waar automatisering het verschil maakt.
Naast het koppelen van bronnen loont het om je bestaande processen onder de loep te nemen en te bepalen welke onderdelen baat hebben bij automatisering. De sleutelvraag daarbij: kun je een taak volledig uit handen geven, uiteraard met menselijke monitoring, of is het beter om een hulpmiddel te bouwen waarmee een medewerker de taak veel makkelijker en beter uitvoert? Drie voorbeelden maken het concreet.
- Trackinginformatie delen met klanten. Vroeger was dit handwerk: containernummer opzoeken, trackinginfo opvragen, mailtje schrijven, versturen, plus alle inkomende mails van klanten die om een statusupdate vragen. Hier wil je eigenlijk helemaal niet mee bezig zijn, en dat hoeft ook niet: dit laat zich volledig automatiseren.
- Facturen van leveranciers verwerken. Dit ligt iets genuanceerder: lange documenten lezen, soms cijfers overtypen. Je kunt de automatisering de factuur laten uitlezen en alles laten klaarzetten voor een laatste controle, waarna een medewerker alleen nog op accepteren hoeft te klikken. Die menselijke tussenstap blijft hier wenselijk, want een computer kan er ook naast zitten, maar dat gold net zo goed toen een mens het volledig deed. Er verandert dus weinig aan de controle, terwijl de tijdwinst enorm is.
- Automatische rapportage, intern én voor klanten. Dit is misschien wel de grootste tijdwinst. Eerst zat je te priegelen in Excel, net niet zoals je het wilde, vaak niet fraai, en een foutje is zo gemaakt. En zodra je klaar was, was het alweer verouderd. Dit alles kan je volledig uit handen geven, en tegelijk dient het als gereedschap voor je data-analisten om met het onderliggende datamodel zelf nieuwe inzichten te ontdekken. De data blijft actueel, ziet er verzorgd uit, en niemand hoeft er nog handmatig aan te sleutelen.
Resultaat in de praktijk: Moovle.
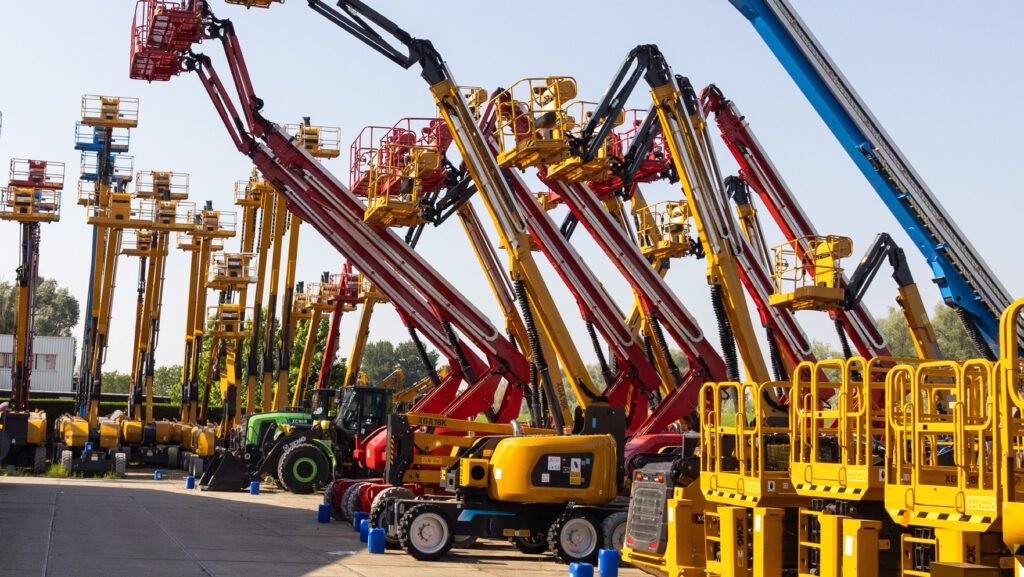
Voor Moovle, actief in de op- en overslag en het vervoer van zwaar materieel, hebben we het volledige plaatje gebouwd dat je hiervoor hebt zien langskomen: een datawarehouse als gemeenschappelijke grond, met daarbovenop de dashboards en automatiseringen die het werk lichter maken. Geen losse onderdelen, maar één samenhangend systeem.
De fundering: een datawarehouse dicht bij huis.
De basis is een (MySQL) datawarehouse op een Europese server, in eigen beheer bij Moovle. Dat was een bewuste keuze. Voorheen las hun rapportagetool rechtstreeks uit het ERP-systeem, en die directe koppeling was fragiel: dashboards liepen vast bij het verversen, en de frequentie waarmee data kon worden opgehaald lag te laag om er operationele beslissingen op te baseren. Bovendien wilde Moovle hun data bewust op Europese bodem houden.
Hun Manager Operations, Process & IT verwoordt het zo:
“We vinden het in deze tijd een risico om al onze data op buitenlandse servers te hebben staan. Daarom voelt het goed om een back-up van onze data nu hier om de hoek te hebben.”
Manager Operations, Process & IT bij Moovle
Sinds het warehouse er ligt, leest hun rapportage niet meer direct uit het ERP maar uit die centrale bron.
Het resultaat: de verversingsfouten verdwenen en de updatefrequentie ging omhoog. Of, in zijn eigen woorden:
“Met het door Newbit ingerichte datawarehouse kunnen we veel vaker en sneller data synchroniseren tussen de bronsystemen en bijvoorbeeld onze BI-omgeving.”
Manager Operations, Process & IT bij Moovle
Systemen laten praten zonder ze te koppelen.
Een mooi voorbeeld van de connector-aanpak in de praktijk: we bouwden een API-tool die de communicatie verzorgt tussen de container-trackingaanbieder en het ERP-systeem. Zo kan de trackingpartij ETA-data (verwachte aankomsttijden) toevoegen en bijwerken in het ERP, zónder daarvoor directe toegang tot dat ERP-systeem te hoeven krijgen. Het warehouse zit ertussen als veilige tussenlaag. Precies het principe waarmee je systemen laat samenwerken zonder ze rechtstreeks aan elkaar te knopen.
Dashboards die het dagelijkse werk sturen.
Op die fundering draaien de dashboards. Financieel geeft het overzicht en grip op de cijfers. Maar de echte winst zit in het operationele deel, waar de data het werk op de vloer op allerlei manieren aanstuurt. Hieronder staan praktijkvoorbeelden van projecten die zijn afgerond, of mogelijk worden gemaakt door het datawarehouse.
- Warehouse planning. In één oogopslag zien wanneer welke zendingen binnenkomen en wanneer ze weer weg moeten. Geen giswerk meer over wat er aankomt.
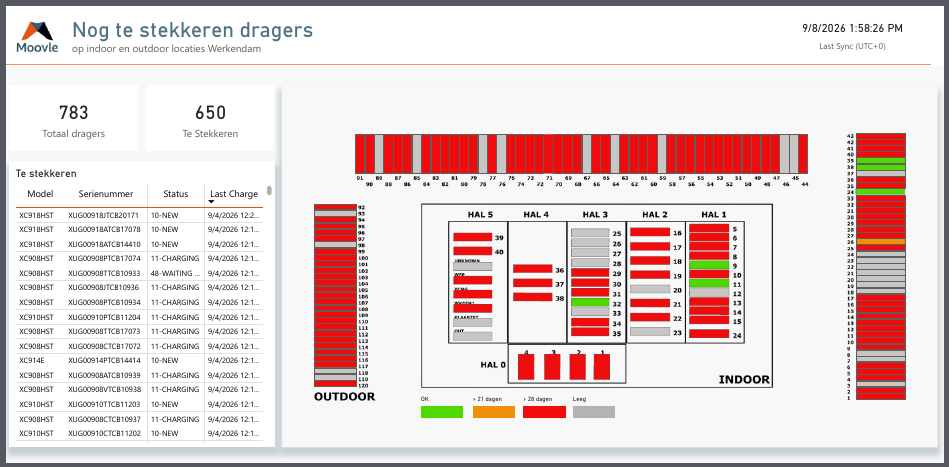
- Warehouse heatmap. Moovle vervoert zwaar elektrisch materieel dat om de zoveel tijd moet worden opgeladen. De heatmap laat in kleur zien welk materieel waar staat en voor hoelang, en vooral: wat nu aan de beurt is om aan de lader te gaan. Daarnaast kan dezelfde plattegrond worden gebruikt om aan te geven waar nog vrije plek is in het warehouse voor nieuwe goederen, of waar een specifiek artikel zich bevindt.
- Inslagen- en uitslagenoverzicht. Welke vrachten komen binnen, en welke moeten worden klaargezet om te vertrekken? De hele goederenstroom in en uit het magazijn, overzichtelijk op één plek.
- Klantportaal. Met informatie over zendingen en transportupdates. Volledig in de huisstijl opgemaakt van het bedrijf en op een veilige manier toegankelijk voor externe gebruikers.
- Geautomatiseerde updates. Voor klanten bij wijzigingen of andere bijzonderheden in hun order. Of voor interne stakeholders om hen te informeren over iets wat dringend aandacht nodig heeft.
- Automatisch opstellen van exportdocumenten. Met AI op basis van alle opgehaalde data.
Van dashboards naar echte automatisering.
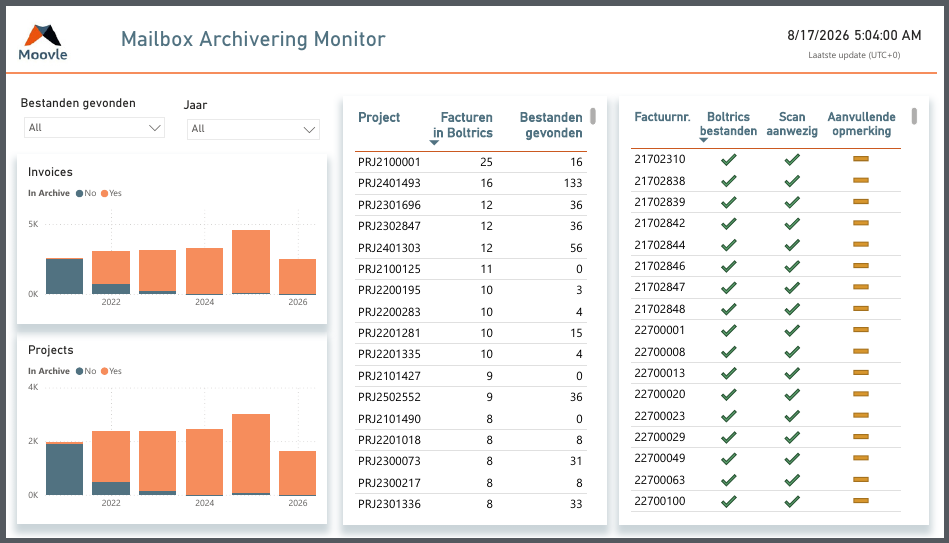
Het bleef niet bij inzicht. Omdat alle data schoon en gestructureerd op één plek stond, konden we er ook processen op laten draaien die werk volledig uit handen nemen. Het duidelijkste voorbeeld is de e-mailarchivering: inkomende facturen met PDF-bijlagen die automatisch aan het juiste project worden gekoppeld en op de juiste plek worden opgeslagen.
De schaal maakt duidelijk waarom dit handwerk nooit een optie was. Het e-mailarchief rondom verkoopfacturatie telt inmiddels zo’n 22.000 berichten. Alleen die bestaande stapel handmatig wegwerken zou bij vijf minuten per e-mail al ruim 1.800 uur kosten: meer dan 200 werkdagen. Nu controleert het systeem elke uitgelezen verwijzing tegen de projectlijst in het warehouse, en komt vrijwel iedere mail tot een sluitende match. Bij de uitzonderingen toont het systeem precies welke documenten nog wachten, zodat ze in een paar klikken op de juiste plek belanden.
En omdat de automatisering elke verwerkingsstap terugschrijft naar het warehouse, ontstond er vanzelf nog iets: een dashboard over de automatisering zelf. De beheerder ziet live hoeveel mails zijn verwerkt, welke projecten nog documenten missen, en hoe vaak het systeem een correctie aanbracht. Dat dashboard was niet vooraf bedacht, het rolde uit het ontwerp, simpelweg omdat alle data nu op één plek beschikbaar was.
Wat het Moovle oplevert.
Het concrete resultaat is een archiveringsproces dat aanmerkelijk betrouwbaarder is dan de eerste versie, plus dashboards waarmee zowel Moovle als wij direct zien wat er speelt. Maar misschien tekenend is hoe de klant zelf de winst omschrijft:
“Archivering is niet per se het leukst om je mee bezig te houden. Daarom ben ik blij dat al onze documenten nu geautomatiseerd en geordend worden opgeslagen.”
Moovle
En het patroon herhaalt zich. De e-mailarchivering was slechts één van meerdere processen die op het warehouse leunen; inmiddels loopt een vergelijkbare aanpak voor terminal-data, die geautomatiseerd in hun ERP-systeem wordt getoond.
“Het datawarehouse geeft ons de mogelijkheid om bijvoorbeeld terminal-data geautomatiseerd in ons eigen ERP-systeem te tonen.”
Moovle
Precies zoals een goede fundering hoort te werken: je bouwt hem één keer, en er blijkt steeds meer op te kunnen.
Lees hier meer over onze Moovle Case
Tot slot: waar sta jij.
Data-gedreven werken in de logistiek is geen kwestie van meer dashboards of nog een extra Excelbestand. Het is een kwestie van de juiste fundering: één gemeenschappelijke grond waar al je bronnen samenkomen, en toepassingen daarbovenop die je mensen ondersteunen in plaats van afleiden. De techniek is er. De vraag is vooral waar jouw organisatie nu staat, en welke eerste stap in jouw situatie de meeste rust oplevert.
Misschien herken je jezelf in één van de drie hoofdvragen waarmee we begonnen: de stortvloed aan data, de twijfel over welke cijfers je kunt vertrouwen, of het effectief informeren van verschillende stakeholders. Misschien heb je al een helder beeld en wil je vooral even sparren over de architectuur, of over de afweging tussen cloud en een eigen server. In beide gevallen hoef je dit niet in één keer uit te denken.
Wil je verkennen wat dit voor jouw organisatie zou betekenen? Soms is een kort gesprek al genoeg om te bepalen waar de grootste winst zit, en of het de moeite waard is om verder te kijken. We denken graag met je mee, vrijblijvend en zonder verkooppraat. Neem gerust contact op, dan plannen we een keer om samen aan de tekentafel te gaan.
Bronnen.
- Carriyo, Connected Fleets: How Telematics and Data Are Powering the Next Generation of Logistics (2025), o.b.v. marktcijfers van Berg Insight.
- S&P Global Market Intelligence (in opdracht van AWS), Data-Driven SMBs Financially Outperform Their Competitors (2025).
- Essenburg, D. (2026, 26 augustus). Arbeid en scholing in de logistiek: Zo gaan ldv’ers ermee om en dit verwachten ze. Logistiek.nl. logistiek.nl
- IBM, geciteerd via Dark Data (Wikipedia-overzicht van IBM-onderzoek naar dataveroudering).
- Gartner-cijfers, samengevat in DataStackHub, Dark Data Statistics for 2025–2026 (2025).
- IBM-schatting, geciteerd in Cogent, Dark Data: Unlocking the ~90% You Don’t Use (2025).
- LiveViewGPS, GPS Industry Statistics 2026 (2026), o.b.v. Mordor Intelligence / MarketsandMarkets.
- Salesforce (2025, 9 september). Wat is datastrategie? Datastrategie uitgelegd: definitie, methodes en voordelen. salesforce.com
- WMSSPL / Syniti, Single Source of Truth Explained: From Data Chaos to Data Trust (2026).
- SnapLogic, Data Distrust (onderzoek uitgevoerd door Vanson Bourne).
- Meerdere onafhankelijke ROI-analyses van wagenparkoplossingen, o.a. FleetRabbit, Fleet Management Software FAQs (2026) en Alliance Fleet Solutions, How to Calculate Telematics ROI (2026).